Informe de resultados: predicción del abandono bancario
Preparación de datos, red neuronal y optimización de hiperparámetros
Autor/a
Equipo de Redes Neuronales
Fecha de publicación
23 de octubre de 2026
Introducción
Este informe documenta de forma reproducible el flujo del proyecto para clasificar el abandono de clientes bancarios (Exited = 1). Se ejecuta desde la raíz del proyecto con quarto render index.qmd. Cada bloque de código puede desplegarse con Mostrar código; las tablas y gráficas se generan a partir de los datos y de los modelos entrenados al renderizar el documento.
La evaluación conserva una partición estratificada de entrenamiento, validación y test. El preprocesador se ajusta solo con entrenamiento, la selección del umbral usa validación y el conjunto de test se reserva para la medición final. Optuna maximiza F1 de validación; por ello, sus resultados no se presentan como una estimación independiente de generalización.
Se lee el CSV original y se reutiliza load_clean() para aplicar las validaciones del proyecto. El proceso elimina identificadores administrativos (RowNumber, CustomerId, Surname), valida el target binario y verifica que no haya valores nulos y que se mantenga el contrato de 15 columnas. Complain se excluye posteriormente del modelado para prevenir fuga de información.
Mostrar código
from pathlib import Pathimport sysimport matplotlib.pyplot as pltimport numpy as npimport pandas as pdimport pytorch_lightning as plimport seaborn as snsimport torchfrom sklearn.metrics import ( auc, confusion_matrix, precision_recall_curve, roc_curve,)ROOT = Path.cwd()ifnot (ROOT /"src").is_dir(): ROOT = Path.cwd().parentifnot (ROOT /"src").is_dir():raiseFileNotFoundError("No se encuentra la carpeta src/ desde el directorio de ejecución.")sys.path.insert(0, str(ROOT))from src.callbacks import F1ThresholdCallbackfrom src.model import ChurnLightningModulefrom src.preprocessing import ChurnDataModule, TARGET_COLUMN, load_clean, load_rawRAW_PATH = ROOT /"data"/"raw"/"Customer-Churn-Records.csv"CLEAN_PATH = ROOT /"data"/"processed"/"df_limpio.csv"raw = load_raw(RAW_PATH)df_clean = load_clean(raw_path=RAW_PATH, cache_path=CLEAN_PATH)print(f"Datos originales: {raw.shape[0]:,} filas × {raw.shape[1]} columnas")print(f"Datos limpios: {df_clean.shape[0]:,} filas × {df_clean.shape[1]} columnas")print(f"Columnas eliminadas durante la limpieza: {sorted(set(raw.columns) -set(df_clean.columns))}")
Datos originales: 10,000 filas × 18 columnas
Datos limpios: 10,000 filas × 15 columnas
Columnas eliminadas durante la limpieza: ['CustomerId', 'RowNumber', 'Surname']
La limpieza no elimina registros ni modifica la etiqueta: descarta campos identificativos y comprueba las condiciones esperadas antes de continuar.
2. Inspección del dataset limpio
Se revisan ejemplos, tipos, valores ausentes y duplicados. Las variables categóricas y numéricas quedan disponibles para el transformador; Exited es la etiqueta que se separa de las características.
No se realiza una imputación global sobre todos los registros. Si hubiera valores ausentes, los imputadores del pipeline aprenderían sus parámetros únicamente a partir del conjunto de entrenamiento.
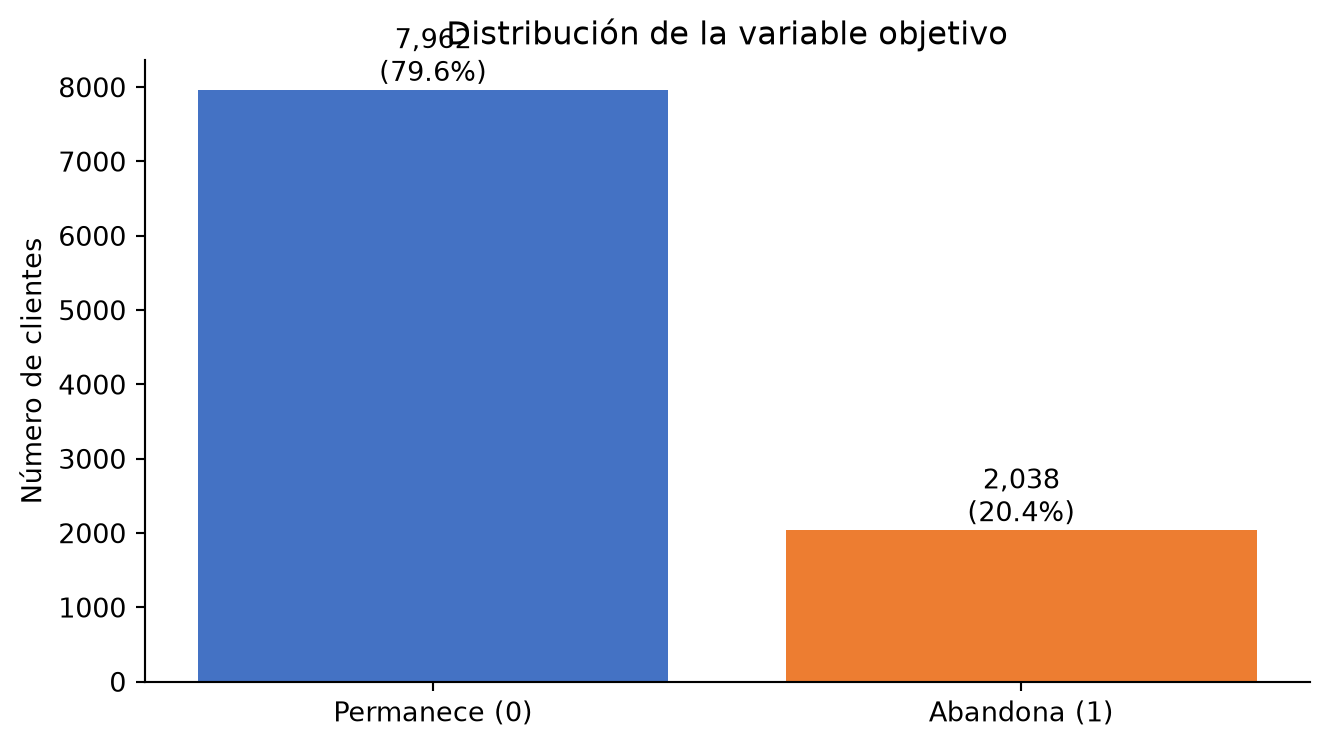
3. Distribución de la variable objetivo
La clase positiva representa a los clientes que abandonaron el banco. La distribución permite identificar el desbalance que motiva el uso de métricas como F1, recall y AUROC, además de la selección del umbral.
Mostrar código
class_counts = df_clean[TARGET_COLUMN].value_counts().reindex([0, 1], fill_value=0)class_rates = class_counts / class_counts.sum()print(f"Tasa de abandono: {class_rates.loc[1]:.2%}")display( pd.DataFrame( {"Clase": ["Permanece (0)", "Abandona (1)"],"clientes": class_counts,"porcentaje": (class_rates *100).round(2), }, index=[0, 1], ).rename(columns={"clientes": "Clientes", "porcentaje": "Porcentaje (%)"}))fig, ax = plt.subplots(figsize=(7, 4))bars = ax.bar( ["Permanece (0)", "Abandona (1)"], class_counts.values, color=["#4472C4", "#ED7D31"],)ax.set(title="Distribución de la variable objetivo", ylabel="Número de clientes")ax.bar_label(bars, labels=[f"{n:,}\n({p:.1%})"for n, p inzip(class_counts, class_rates)])ax.spines[["top", "right"]].set_visible(False)plt.tight_layout()plt.show()
Tasa de abandono: 20.38%
Clase
Clientes
Porcentaje (%)
0
Permanece (0)
7962
79.62
1
Abandona (1)
2038
20.38
4. División y preparación del modelo (DataModule)
ChurnDataModule divide los datos de forma estratificada (80/10/10), retira Complain de las características y ajusta el ColumnTransformer solo con entrenamiento. Las variables financieras reciben log1p, recorte IQR y escalado robusto; el resto de numéricas se recorta y escala, y las categóricas se imputan y codifican mediante one-hot encoding.
Mostrar código
data = ChurnDataModule(df_clean, batch_size=64)data.setup()split_rows = []for split_name, indices in data.split_indices.items(): labels = df_clean.iloc[indices][TARGET_COLUMN] split_rows.append( {"Partición": {"train": "Entrenamiento", "val": "Validación", "test": "Test"}[split_name],"Registros": len(indices),"Porcentaje (%)": len(indices) /len(df_clean) *100,"Tasa de abandono (%)": labels.mean() *100, } )display(pd.DataFrame(split_rows).round(2))print(f"Dimensión de entrada tras el preprocesamiento: {data.input_dim}")print(f"Columnas en el DataModule: {data.frame.shape[1]} (incluye la etiqueta)")print(f"Complain está excluida: {'Complain'notin data.frame.columns}")
Partición
Registros
Porcentaje (%)
Tasa de abandono (%)
0
Entrenamiento
8000
80.0
20.38
1
Validación
1000
10.0
20.40
2
Test
1000
10.0
20.40
Dimensión de entrada tras el preprocesamiento: 19
Columnas en el DataModule: 14 (incluye la etiqueta)
Complain está excluida: True
Valor
Explicación
Fórmula
registros
Número de filas asignadas a la partición.
Conteo de filas
porcentaje
Peso de la partición sobre el conjunto completo.
registros / total × 100
tasa de abandono
Porcentaje de clientes con Exited = 1.
abandono / registros × 100
El resultado se convierte a tensores float32. La partición fija con semilla 42 facilita la comparación entre ejecuciones, aunque no sustituye una validación con varias semillas o una evaluación temporal.
Pruebas automatizadas
El proyecto incluye tests/test_preprocessing.py, que se ejecuta con pytest. Las nueve pruebas comprueban que se eliminan los identificadores, que el target es binario, que no hay nulos ni duplicados, que las tres particiones conservan una tasa de abandono similar, que las formas de los tensores coinciden y que Complain no llega a las características. También verifican que la dimensión final de entrada es 19. Estas pruebas detectan regresiones en la preparación de datos antes de iniciar un entrenamiento.
5. Exploración, entrenamiento y test del modelo
El clasificador implementado es una red residual para datos tabulares: capa inicial, bloques Linear → BatchNorm → Mish → Dropout → Linear con conexión residual y una salida logit. La pérdida focal enfatiza ejemplos difíciles; la implementación también admite entropía cruzada binaria ponderada.
Para que el informe pueda ejecutarse en un tiempo razonable, se limita el entrenamiento de cada modelo a 30 épocas con parada temprana (paciencia 6). Se guarda y evalúa el checkpoint con mayor F1 en validación. El callback selecciona el umbral exclusivamente con validación y ese umbral se aplica al test sin ajustarlo con sus etiquetas.
Formato de los entrenamientos históricos
Los experimentos anteriores se organizaron como una ablación: cada variante modifica una característica respecto a su referencia. Esta tabla conserva ese formato para que las configuraciones de la sección 6 puedan interpretarse sin confundir una diferencia de arquitectura con una diferencia de optimización. El modelo C es la referencia histórica y se muestra en negrita.
Exp.
Topología
Capas ocultas
Neuronas totales
Batch
LR
Dropout
A
[32]
1
32
32
1e-3
0.0
B
[64, 32]
2
96
32
1e-3
0.0
C (base histórico)
[128, 64, 32]
3
224
32
1e-3
0.0
E
[128, 64, 32, 16]
4
240
32
1e-3
0.3
F1
[32, 32, 32]
3
96
32
1e-3
0.0
F2
[64, 64, 64]
3
192
32
1e-3
0.0
F3
[128, 128, 128]
3
384
32
1e-3
0.3
G
[64, 32]
2
96
64
1e-3
0.0
H1
[64, 32]
2
96
32
5e-4
0.0
H2
[64, 32]
2
96
32
1e-4
0.0
La tabla histórica se presenta como referencia experimental. El bloque de código que sigue entrena el modelo residual actual del proyecto; no se reconstruyen automáticamente las arquitecturas antiguas porque pertenecen a una implementación anterior. Por tanto, la comparación histórica de la sección 6 y la evaluación ejecutable del modelo actual deben leerse como dos fuentes complementarias.
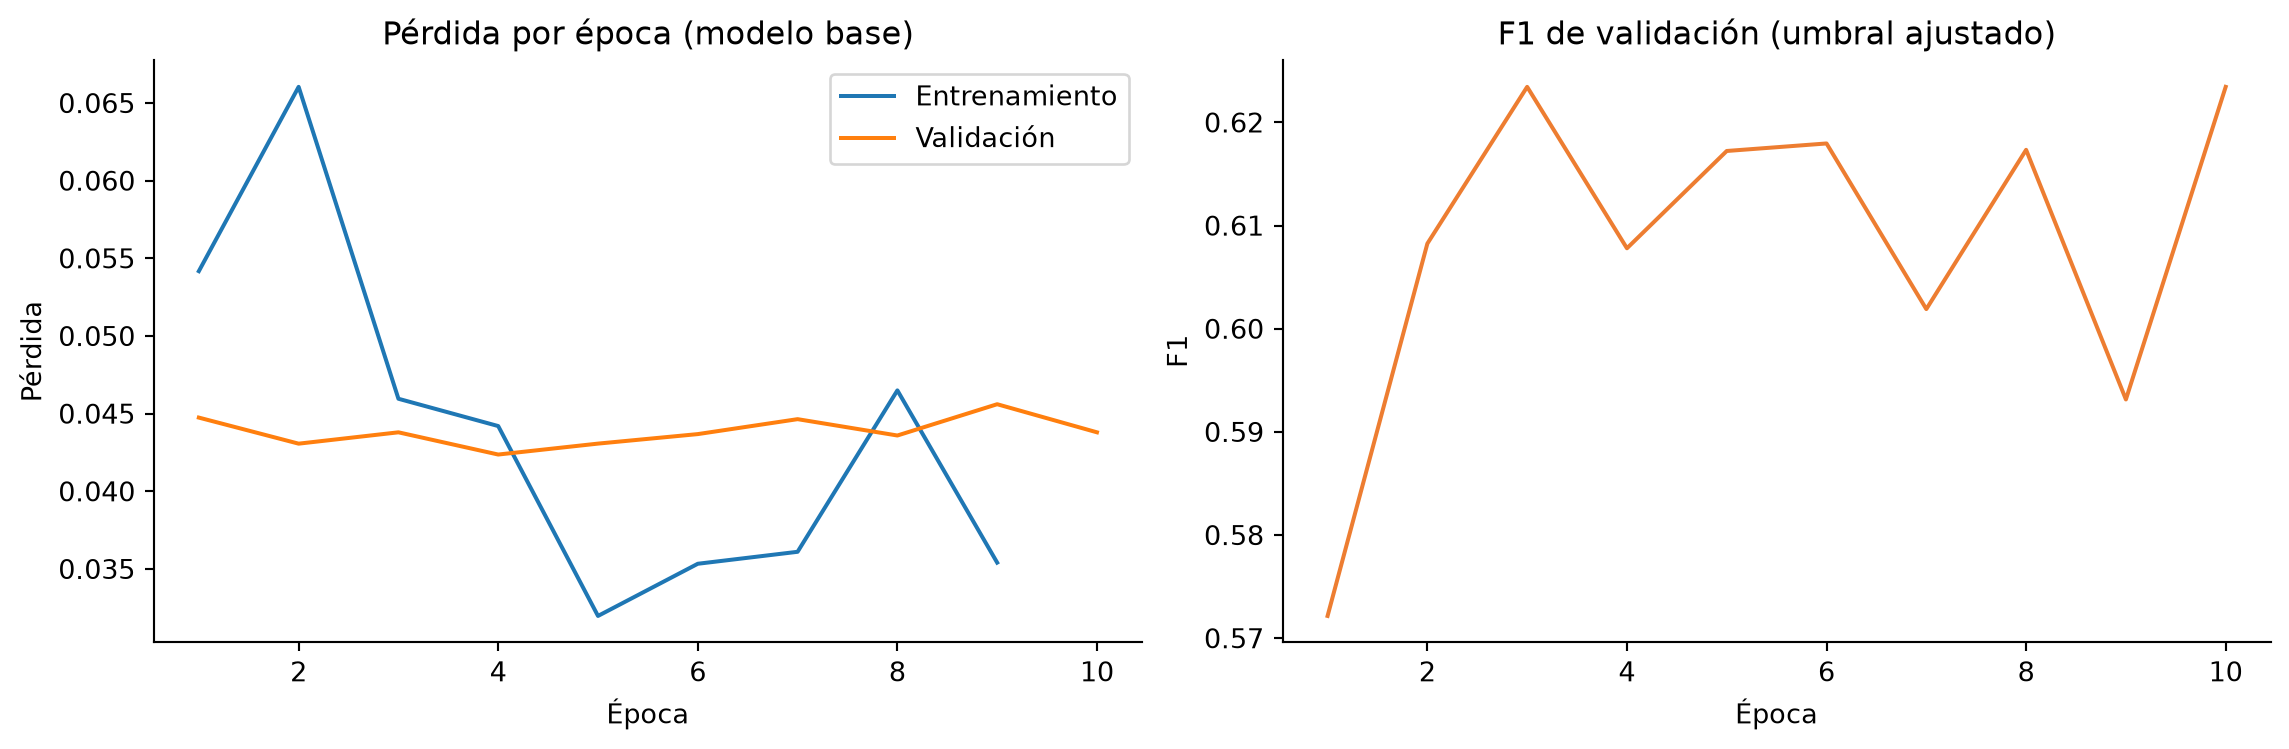
La siguiente gráfica muestra las pérdidas y el F1 de validación del modelo base. La selección del checkpoint y la parada temprana utilizan el F1 de validación; no se emplea el test para tomar decisiones de entrenamiento.
Mostrar código
history_base = baseline["historial"]fig, axes = plt.subplots(1, 2, figsize=(12, 4))axes[0].plot(history_base["época"], history_base["pérdida_entrenamiento"], label="Entrenamiento")axes[0].plot(history_base["época"], history_base["pérdida_validación"], label="Validación")axes[0].set(title="Pérdida por época (modelo base)", xlabel="Época", ylabel="Pérdida")axes[0].legend()axes[1].plot(history_base["época"], history_base["F1_validación"], color="#ED7D31")axes[1].set(title="F1 de validación (umbral ajustado)", xlabel="Época", ylabel="F1")for ax in axes: ax.spines[["top", "right"]].set_visible(False)plt.tight_layout()plt.show()
Elemento
Explicación
Lectura
Pérdida de entrenamiento
Línea azul: error medio en los datos usados para ajustar el modelo.
Menor es mejor
Pérdida de validación
Línea naranja: error medio en datos no usados para actualizar los pesos.
Menor es mejor; una separación creciente puede indicar sobreajuste
F1 de validación
Línea naranja del panel derecho, calculada con el umbral ajustado en cada época.
Mayor y estable ayuda a elegir el checkpoint
6. Análisis de resultados del modelo base
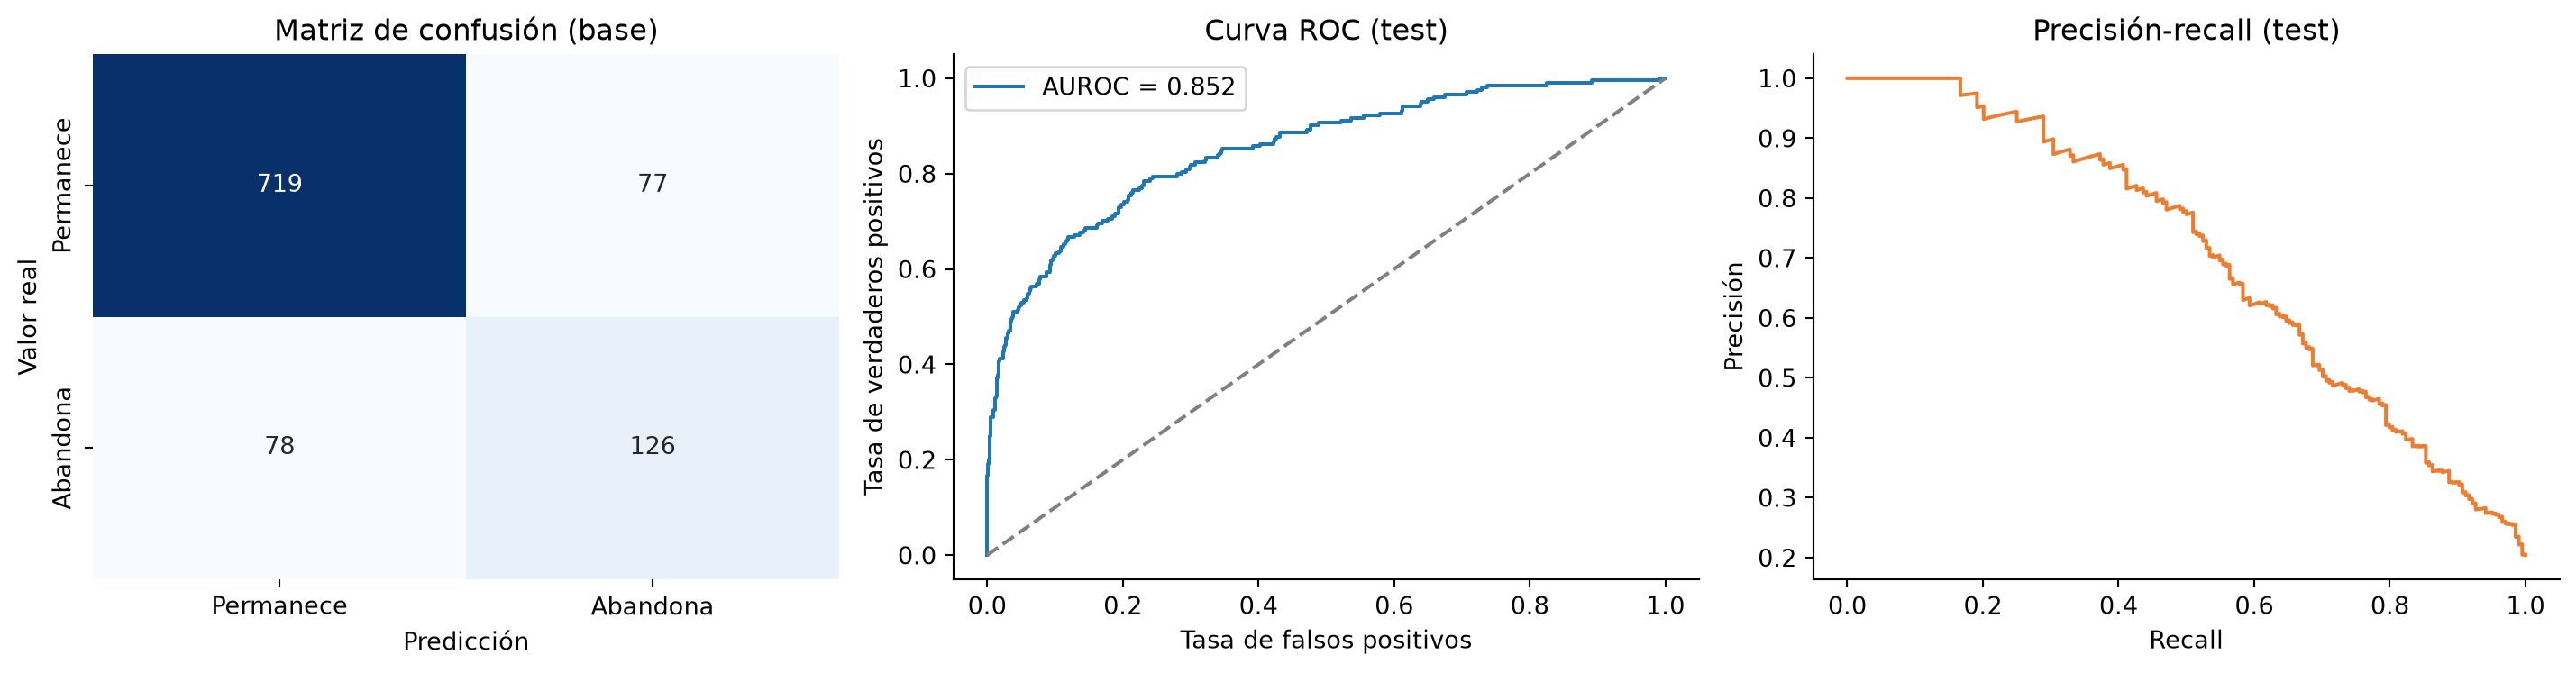
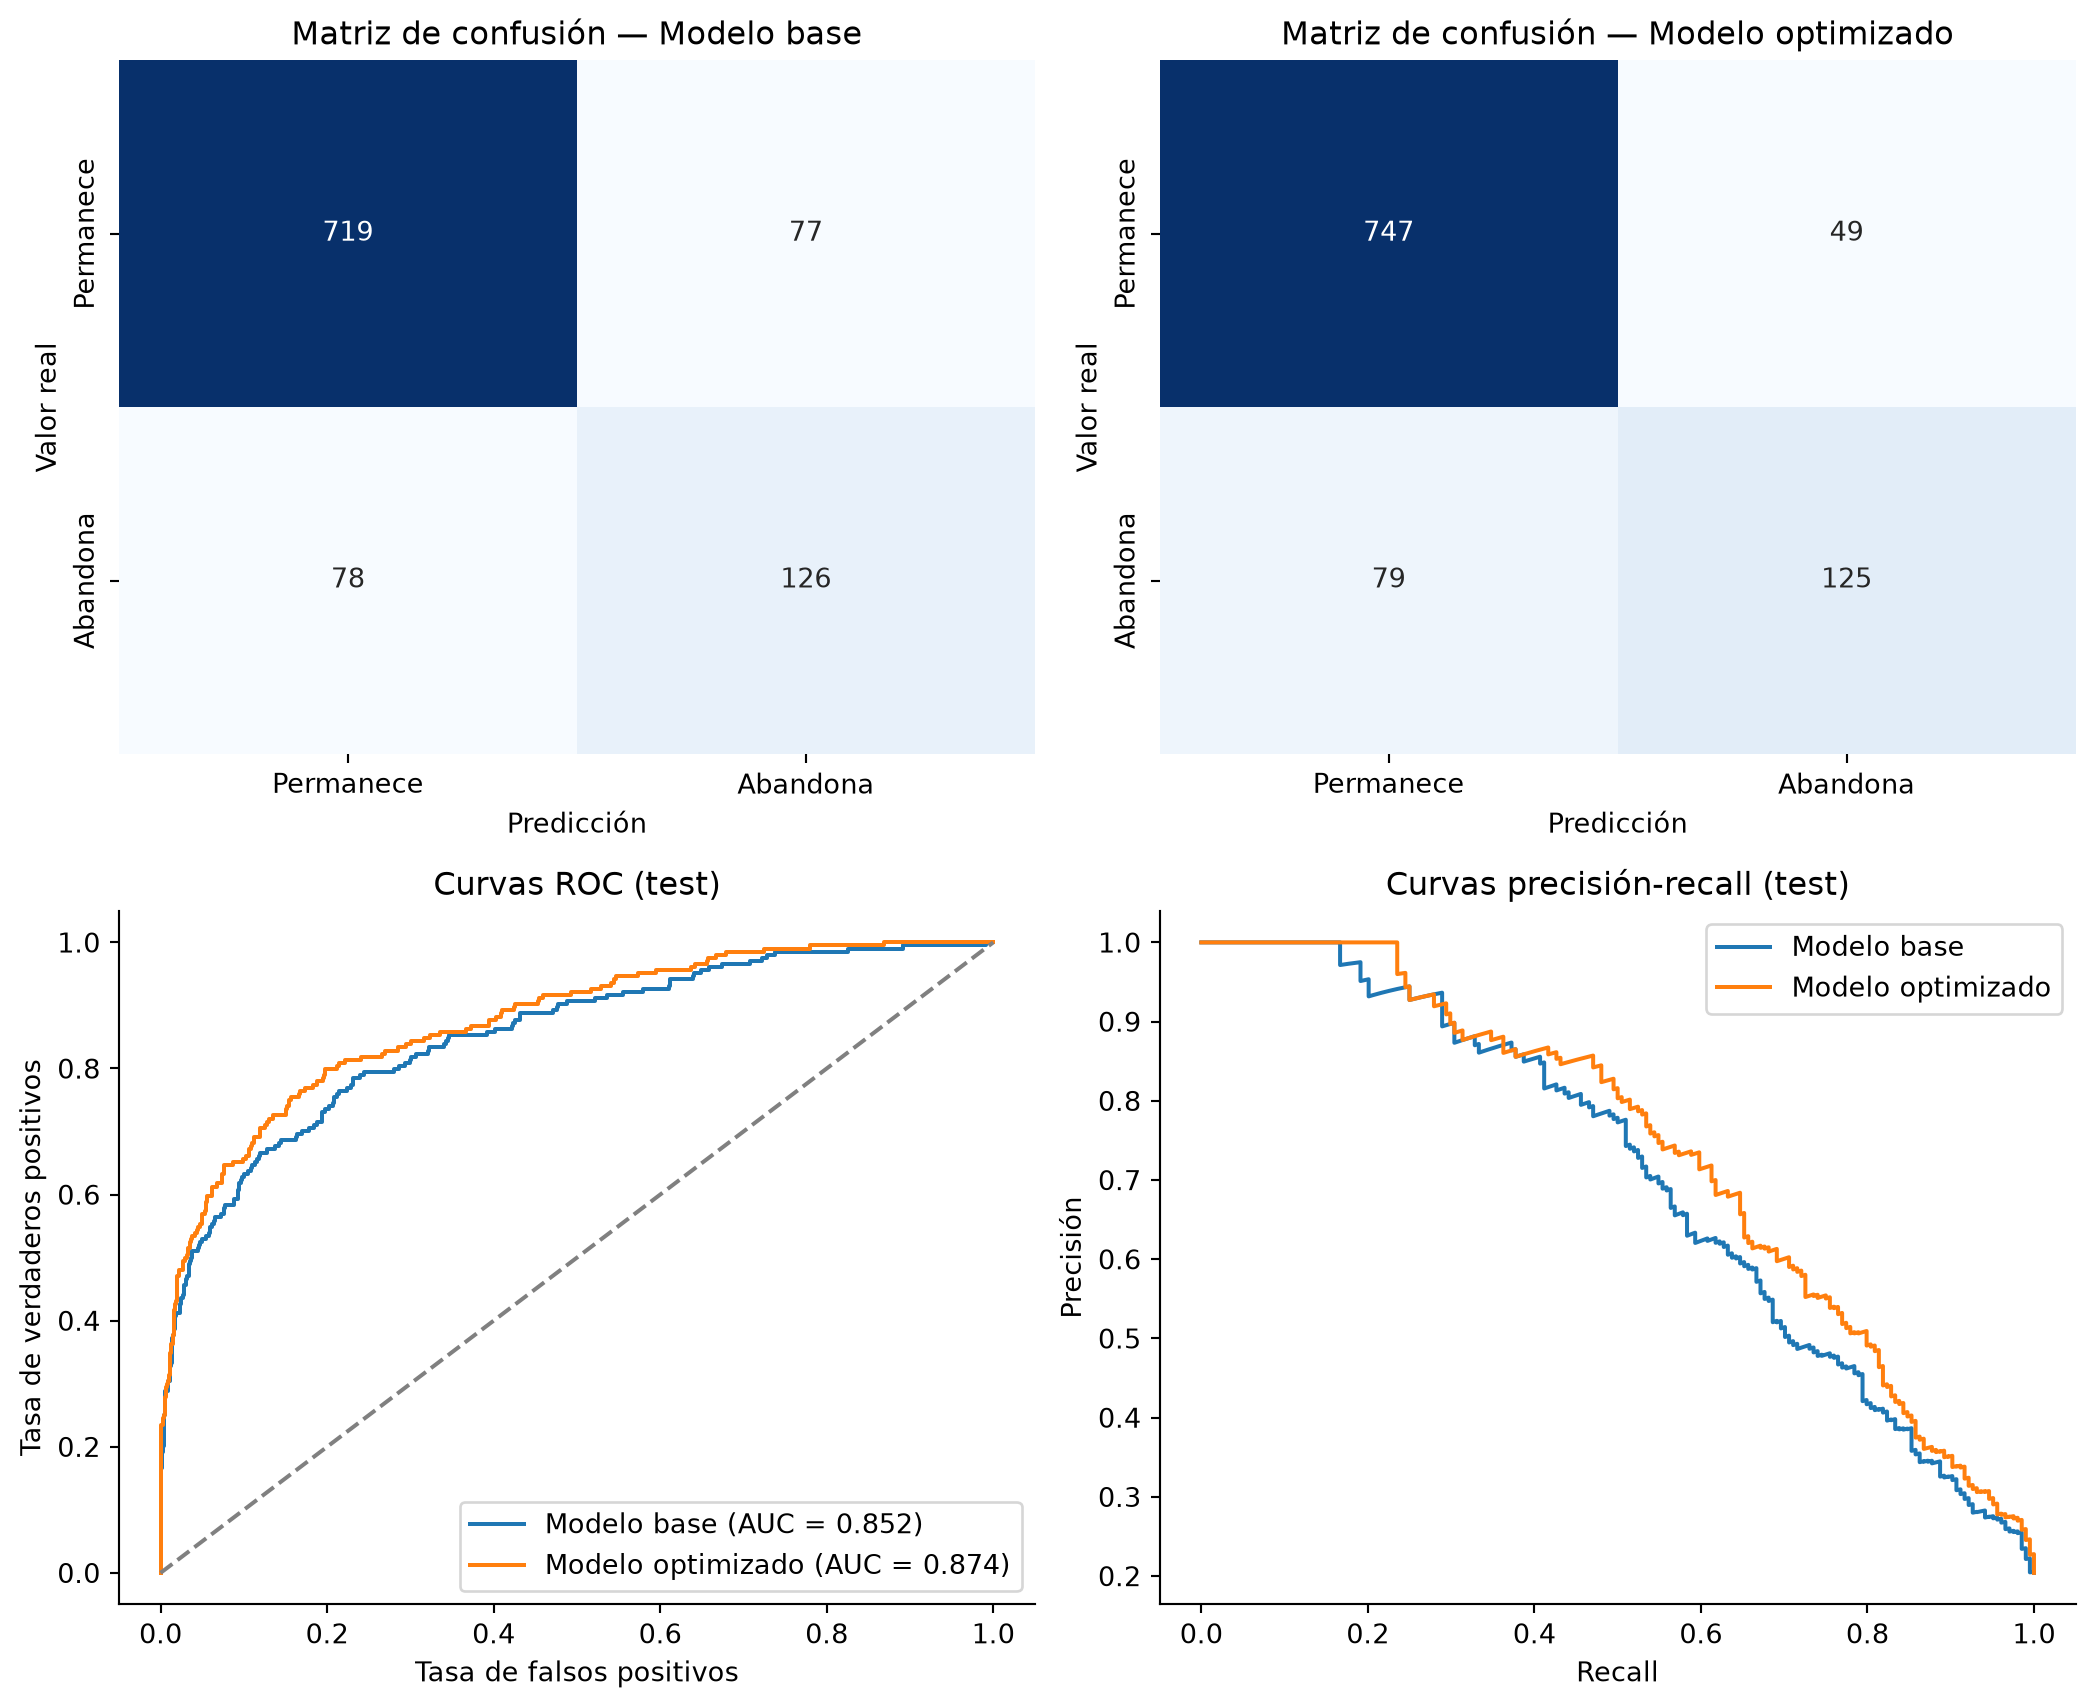
Se informan métricas del conjunto de test con el umbral elegido en validación. La matriz de confusión permite apreciar falsos positivos y falsos negativos; las curvas ROC y precisión-recall resumen el comportamiento al variar el umbral. Al estar desbalanceadas las clases, la exactitud por sí sola no es suficiente para valorar el modelo.
Comparación con arquitecturas anteriores
La siguiente tabla reúne los experimentos realizados antes de consolidar el flujo actual. Se conservan únicamente las métricas que produce el modelo base actual, con el mismo orden y formato. Los valores históricos disponibles son medias ± desviaciones estándar.
Filas: clase real; columnas: clase predicha. La diagonal son aciertos y el resto errores.
Celdas TN, FP, FN, TP
Curva ROC, eje X
Tasa de falsos positivos.
FPR = FP / (FP + TN)
Curva ROC, eje Y
Tasa de verdaderos positivos, equivalente a recall.
TPR = TP / (TP + FN)
Diagonal ROC
Rendimiento de un clasificador aleatorio.
TPR = FPR
Curva precisión-recall
Relación entre los abandonos detectados y la fiabilidad de las predicciones positivas.
Eje X: Recall; eje Y: Precision
Área mayor
Mejor separación ROC o mejor equilibrio entre detectar abandonos y limitar falsas alarmas.
Mayor AUC o mayor área PR
Las cifras de test corresponden a una única partición aleatoria estratificada. Son una referencia para este experimento, no una garantía de rendimiento en clientes futuros.
7. Optimización y ajustes al modelo con Optuna
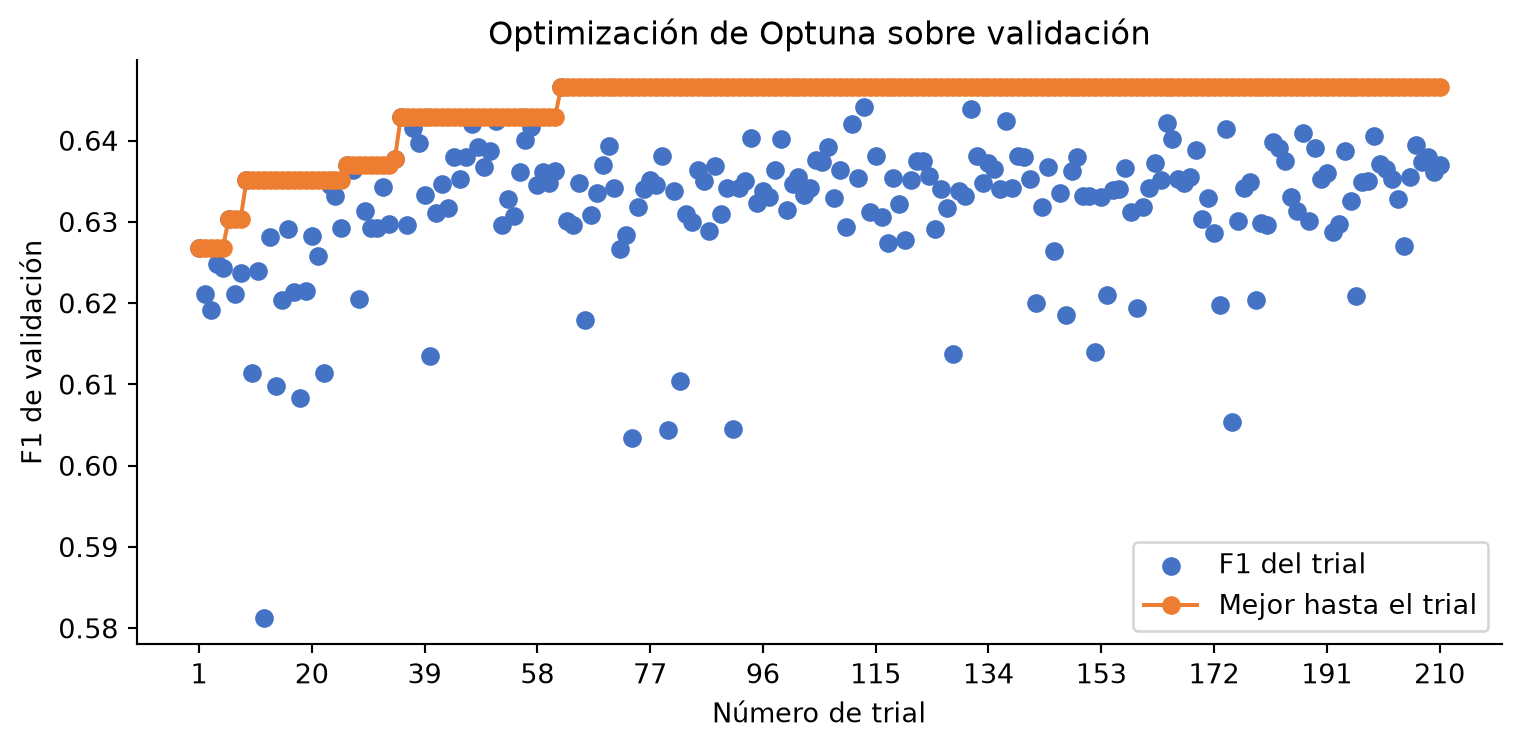
La búsqueda explora los hiperparámetros del modelo y la configuración del entrenamiento, con el mismo conjunto de validación y la misma métrica objetivo (F1 con umbral seleccionado en validación). Cada trial se evalúa con tres semillas y se puntúa con su F1 medio, lo que reduce la dependencia de una única inicialización. Optuna guarda el estudio en SQLite para poder reanudarlo y usa pruning para detener configuraciones poco prometedoras. El conjunto de test no participa en la búsqueda.
Cuando Optuna está habilitado, la gráfica muestra la evolución del mejor F1 de validación a medida que se completan los trials. Los trials podados o fallidos no se incluyen. La búsqueda no se interpreta como exhaustiva ni como prueba de mejora estadística.
Para ejecutar o reanudar la búsqueda desde la raíz del proyecto se puede usar:
OPTUNA_TRIALS=30 \quarto render index.qmd
La base Redes neuronales/artifacts/optuna/optuna.db conserva los trials anteriores. Para añadir más trials basta con volver a ejecutar el comando aumentando OPTUNA_TRIALS; para empezar un estudio limpio se debe eliminar esa base SQLite antes de renderizar.
Si se omite OPTUNA_TRIALS o se establece en 0, no se crean trials nuevos. El informe carga el mejor trial disponible en la base y lo compara con el modelo base. Si la base no contiene trials completados, solo se muestra el modelo base.
quarto render index.qmd
Mostrar código
study =Noneoptimized =Nonebest_params = {}best_seed_scores = []trial_values = []if OPTUNA_ENABLED:from src.optuna_search import run_study study = run_study( frame=df_clean, database_path=OPTUNA_DB, n_trials=N_TRIALS, seeds=OPTUNA_SEEDS, max_epochs=OPTUNA_EPOCHS, patience=OPTUNA_PATIENCE, study_name=OPTUNA_STUDY_NAME, ) completed_trials = [ trial for trial in study.trials if trial.value isnotNone ] OPTUNA_RUN =bool(completed_trials) trials_table = study.trials_dataframe( attrs=("number", "value", "state", "params", "user_attrs", "duration") ) display(trials_table)if OPTUNA_RUN:print(f"Mejor F1 de validación: {study.best_value:.4f}")print(f"Mejor trial: {study.best_trial.number}")elif N_TRIALS ==0:print("No hay trials completados en la base de Optuna.")print(f"Base de datos SQLite: {OPTUNA_DB}") trial_numbers = [ trial.number +1for trial in study.trials if trial.value isnotNone ] trial_values = [ trial.value for trial in study.trials if trial.value isnotNone ]if trial_values: best_so_far = np.maximum.accumulate(trial_values) fig, ax = plt.subplots(figsize=(8, 4)) ax.scatter(trial_numbers, trial_values, color="#4472C4", label="F1 del trial") ax.plot( trial_numbers, best_so_far, color="#ED7D31", marker="o", label="Mejor hasta el trial", ) ax.set( title="Optimización de Optuna sobre validación", xlabel="Número de trial", ylabel="F1 de validación", ) max_x_ticks =12iflen(trial_numbers) <= max_x_ticks: visible_trial_ticks = trial_numberselse: tick_indices = np.linspace(0, len(trial_numbers) -1, max_x_ticks, dtype=int ) visible_trial_ticks = [trial_numbers[index] for index in tick_indices] ax.set_xticks(visible_trial_ticks) ax.legend() ax.spines[["top", "right"]].set_visible(False) plt.tight_layout() plt.show()else:print("No hay resultado de Optuna para comparar; se evaluará únicamente el modelo base.")
number
value
state
params_batch_size
params_dropout
params_focal_alpha
params_focal_gamma
params_hidden_dim
params_learning_rate
params_loss_name
params_num_blocks
params_weight_decay
user_attrs_seed_scores
duration
0
0
0.626758
COMPLETE
64
0.486459
0.595553
3.413549
256
0.001111
focal
4
0.000001
[0.62381, 0.620499, 0.635965]
0 days 00:00:12.488172
1
1
0.621093
COMPLETE
128
0.403329
0.731405
1.198858
128
0.000348
focal
2
0.000067
[0.623853, 0.613811, 0.625616]
0 days 00:00:08.577333
2
2
0.619168
COMPLETE
128
0.248069
0.722830
0.927134
128
0.000139
focal
2
0.000546
[0.615385, 0.614213, 0.627907]
0 days 00:00:10.782639
3
3
0.624789
COMPLETE
64
0.452672
0.914843
2.592650
128
0.001396
focal
5
0.005728
[0.624366, 0.62, 0.63]
0 days 00:00:18.495550
4
4
0.624345
COMPLETE
64
0.410989
0.944099
0.760927
128
0.000633
weighted_bce
2
0.000004
[0.626263, 0.623116, 0.623656]
0 days 00:00:11.881415
...
...
...
...
...
...
...
...
...
...
...
...
...
...
...
205
205
0.639440
COMPLETE
32
0.412033
0.520892
1.571229
128
0.002324
focal
5
0.000070
[0.636943, 0.639456, 0.641921]
0 days 00:00:36.237105
206
206
0.637321
COMPLETE
32
0.391174
0.546673
1.359042
128
0.002297
focal
5
0.000117
[0.63747, 0.632124, 0.642369]
0 days 00:00:34.124152
207
207
0.637968
COMPLETE
32
0.485794
0.658450
0.823990
128
0.002219
focal
5
0.000183
[0.642686, 0.638614, 0.632603]
0 days 00:00:37.973733
208
208
0.636165
COMPLETE
32
0.440528
0.516265
1.525182
128
0.002589
focal
5
0.000229
[0.632075, 0.642512, 0.633907]
0 days 00:00:33.061740
209
209
0.637051
COMPLETE
32
0.477116
0.639637
1.007888
128
0.001772
focal
5
0.000200
[0.639456, 0.632353, 0.639344]
0 days 00:00:35.349078
210 rows × 14 columns
Mejor F1 de validación: 0.6466
Mejor trial: 61
Base de datos SQLite: /home/adra/Documents/projects/Proyecto-IA/Redes neuronales/artifacts/optuna/optuna.db
8. Análisis de resultados optimizados
El mejor conjunto de hiperparámetros se vuelve a entrenar desde cero y se evalúa en el mismo conjunto de test que el modelo base. Esta comparación mantiene las observaciones de test constantes; la mejora observada debe interpretarse con cautela porque la configuración se seleccionó usando validación.
Mostrar código
if OPTUNA_RUN: best_params =dict(study.best_params) optimized = fit_and_evaluate(best_params, "optuna", seed=42) best_seed_scores = study.best_trial.user_attrs.get("seed_scores", []) comparison = pd.DataFrame( [threshold_metrics(baseline), threshold_metrics(optimized)], index=["Modelo base", "Modelo optimizado"], )else: comparison = pd.DataFrame( [threshold_metrics(baseline)], index=["Modelo base"], )display(comparison.round(4))if OPTUNA_RUN:print(f"Parámetros seleccionados: {best_params}")print(f"F1 de validación por semilla: {best_seed_scores}")if best_seed_scores:print(f"F1 medio de validación: {np.mean(best_seed_scores):.4f}")print(f"Umbral optimizado elegido en validación: {optimized['umbral']:.4f}")print(f"Métricas de test del modelo optimizado: {optimized['metricas']}")
accuracy
precision
recall
F1
AUROC
umbral
TN
FP
FN
TP
Modelo base
0.845
0.6207
0.6176
0.6192
0.8518
0.5599
719
77
78
126
Modelo optimizado
0.872
0.7184
0.6127
0.6614
0.8742
0.4794
747
49
79
125
Parámetros seleccionados: {'batch_size': 32, 'loss_name': 'focal', 'hidden_dim': 128, 'num_blocks': 5, 'learning_rate': 0.0027262466408143095, 'weight_decay': 0.00011586602173730707, 'dropout': 0.4243950763241853, 'focal_gamma': 1.6365827207776655, 'focal_alpha': 0.5511585626407826}
F1 de validación por semilla: [0.6426966190338135, 0.6503667235374451, 0.646766185760498]
F1 medio de validación: 0.6466
Umbral optimizado elegido en validación: 0.4794
Métricas de test del modelo optimizado: {'test_loss': 0.054746150970458984, 'test_threshold': 0.4793948233127594, 'test_accuracy': 0.871999979019165, 'test_precision': 0.7183908224105835, 'test_recall': 0.6127451062202454, 'test_f1': 0.6613756418228149, 'test_auroc': 0.8742117881774902}
Se comparan tanto métricas agregadas como las matrices de confusión y curvas ROC. El umbral de cada modelo se eligió de forma independiente usando su validación, no sobre el conjunto de test.
Los resultados que siguen se calculan directamente de las ejecuciones de este informe. Una diferencia positiva de F1 o AUROC en la partición de test es descriptiva de esta corrida, pero no acredita por sí sola una mejora generalizable.
Mostrar código
base_f1 = threshold_metrics(baseline)["F1"]base_auc = threshold_metrics(baseline)["AUROC"]print(f"F1 de test — modelo base: {base_f1:.4f}")print(f"AUROC de test — modelo base: {base_auc:.4f}")if OPTUNA_RUN: tuned_f1 = threshold_metrics(optimized)["F1"] tuned_auc = threshold_metrics(optimized)["AUROC"] delta_f1 = tuned_f1 - base_f1 delta_auc = tuned_auc - base_aucprint(f"F1 de test — modelo optimizado: {tuned_f1:.4f} ({delta_f1:+.4f})")print(f"AUROC de test — modelo optimizado: {tuned_auc:.4f} ({delta_auc:+.4f})")print(f"Trials completados: {len(trial_values)}")else:print("Optuna no se ejecutó; no hay comparación optimizada.")
F1 de test — modelo base: 0.6192
AUROC de test — modelo base: 0.8518
F1 de test — modelo optimizado: 0.6614 (+0.0422)
AUROC de test — modelo optimizado: 0.8742 (+0.0224)
Trials completados: 210
El flujo elimina identificadores y Complain, conserva la etiqueta binaria y ajusta el preprocesamiento únicamente con entrenamiento.
La partición estratificada mantiene proporciones comparables entre train, validación y test. La selección del umbral y de los hiperparámetros se limita a validación.
La comparación de métricas en test permite describir el modelo base frente al modelo optimizado en esta ejecución. La conclusión debe considerar precision, recall, F1, AUROC y los tipos de error, no solo accuracy.
Para una conclusión más robusta conviene repetir con varias semillas, evaluar temporalmente, analizar posibles sesgos y ponderar el coste de los falsos negativos antes de usar el modelo en decisiones reales.
El conjunto de datos tiene carácter demostrativo. No se recomienda utilizar estas predicciones como política de retención de clientes sin validación adicional, análisis de impacto y revisión del dominio.